Claude Duet, Grok Bot, Muse : la fin du micromanagement
Grok Bot, Muse, Dots, Claude Duet : les IA deviennent des agents toujours actifs. Mon avis de dev : on passe du human in the loop au human on the loop.
En dix semaines, xAI, Meta, OpenAI et Anthropic ont sorti la même chose : un agent IA toujours actif, qui travaille en arrière-plan sur son propre ordinateur et revient vers vous quand il a besoin d'une décision. Pour moi, ce n'est pas une nouvelle fonctionnalité de chatbot, c'est un vrai changement de méthode : on arrête de micromanager l'IA, on lui pose un cadre et on juge son travail.
Je vous le dis tout de suite : je n'ai testé aucun de ces produits. Par contre, j'ai construit au travail un agent qui fait déjà une partie de ce qu'ils promettent, et c'est depuis cette place que j'écris.
Sommaire
- Ce qui est sorti cet automne
- Du human in the loop au human on the loop
- Blue, mon agent au travail
- Le nouveau rôle du développeur
- Et ce n'est pas propre au développement
- Et si on acceptait les erreurs silencieuses ?
- Alors, prêt à passer sur du « on the loop » ?
Ce qui est sorti cet automne
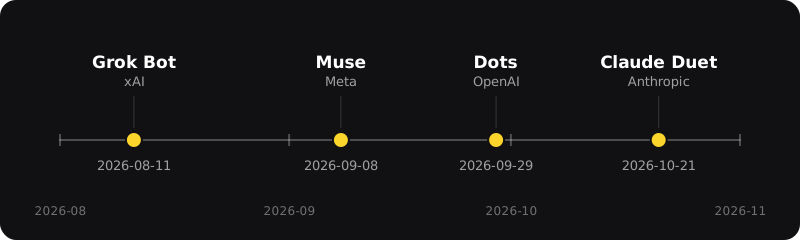
| Sortie | L'idée | Accès | |
|---|---|---|---|
| Grok Bot (xAI) | 11 août 2026, bêta | Une équipe d'agents toujours actifs qui partagent un ordinateur dans le cloud et se coordonnent en conversation de groupe | Abonnements payants xAI et Cursor (au lancement) |
| Muse (Meta) | 8 septembre 2026 | Un agent personnel grand public : avatar en vidéo, adresse e-mail dédiée, contrôle du Mac annoncé fin septembre | États-Unis et Canada |
| Dots (OpenAI) | 29 septembre 2026 | Des agents dans ChatGPT qui poursuivent un objectif sans être guidés pas à pas, chacun sur son ordinateur dans le cloud | ChatGPT Pro et Business Premium |
| Claude Duet (Anthropic) | 21 octobre 2026, aperçu de recherche | Un brief le matin, puis le silence jusqu'à ce qu'il ait besoin de vous | Liste d'attente, abonnés américains |
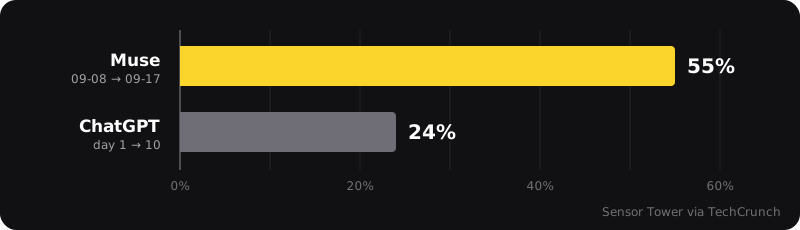
Et le public suit. Muse a dépassé les 3,4 millions de téléchargements en moins de trois semaines (selon Sensor Tower, cité par TechCrunch). Petit point de comparaison : sur ses premiers jours, ses téléchargements ont progressé de 55 % en moyenne d'un jour sur l'autre, contre 24 % pour ChatGPT à son lancement.
Par contre, en France, on regarde tout ça de loin : Muse est réservé aux États-Unis et au Canada, Claude Duet aux abonnés américains, et l'offre Pro de Dots exclut l'Espace économique européen.
Du human in the loop au human on the loop
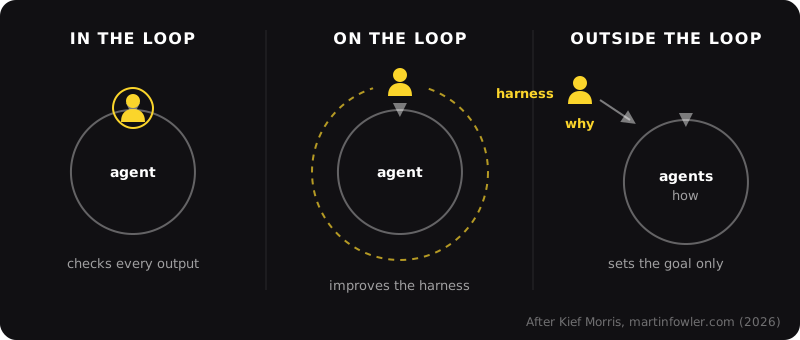
Pour bien situer l'humain face aux agents, je reprends les trois positions décrites par Kief Morris (Thoughtworks) dans Humans and Agents in Software Engineering Loops, publié en mars 2026 sur le site de Martin Fowler :
- In the loop : l'humain contrôle à l'intérieur de la boucle, par exemple en vérifiant chaque ligne générée, et corrige directement le résultat. C'est du micromanagement.
- On the loop : l'humain construit et pilote la boucle, c'est-à-dire le harness (les specs, les contrôles qualité, les consignes). Quand le résultat ne va pas, il change le harness qui l'a produit. Comme l'écrit Morris : « Rather than personally inspecting what the agents produce, we can make them better at producing it. »
- Outside the loop : l'humain ne garde que le « pourquoi » et laisse tout le « comment » aux agents. C'est le vibe coding.
Avec les premiers assistants, on était in the loop. On découpait la tâche, on guidait chaque étape, on relisait chaque ligne produite. L'IA était un outil qu'on tenait par la main.
Avec les modèles de cette année, on est entré dans l'ère agentique, et beaucoup de nos besoins peuvent maintenant être confiés en partie à un agent. La méthode change :
- on définit le besoin ensemble ;
- le développeur pose le cadre ;
- l'IA fait le reste ;
- le développeur vérifie le résultat et fait ses retours, non plus sur le code, mais SURTOUT sur la réflexion : l'analyse et l'implémentation que l'IA a choisies.
C'est ça, le passage au human on the loop : l'humain ne fait plus tout lui-même. Il construit le cadre, il garde les décisions, et il reprend la main aux moments qui comptent.
D'ailleurs, les quatre produits ne placent pas l'humain au même endroit. Claude Duet garde une validation sur les actions sensibles (il demande avant d'envoyer un message ou de payer). Grok Bot va beaucoup plus loin : ses agents se répartissent le travail entre eux et ne vous sollicitent que pour les arbitrages.
Blue, mon agent au travail
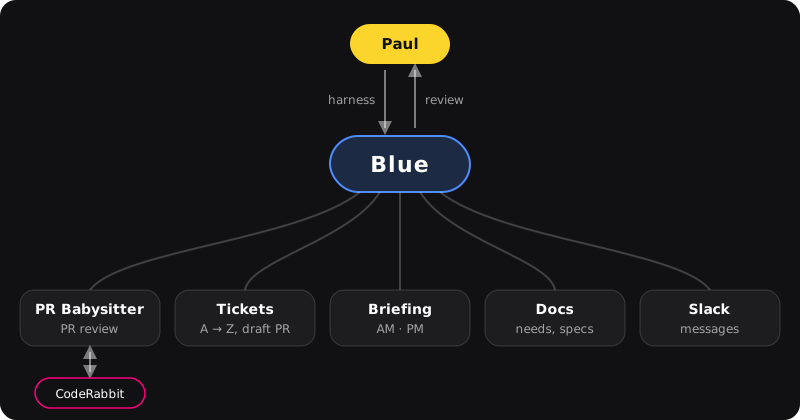
Je n'ai pas attendu ces produits. Au travail, j'utilise un agent que j'ai appelé Blue, qui m'épaule au quotidien sur les tickets. En réalité, c'est toute une équipe de sous-agents :
- PR Babysitter surveille mes pull requests : il vérifie le contenu, échange avec CodeRabbit (l'outil de revue de code par IA) et me fait ses retours ;
- un agent prend les tickets simples (et je dis bien simples) et les traite de A à Z, jusqu'à ouvrir une PR en draft, que je relis avant quoi que ce soit ;
- un agent me fait un briefing le matin, et un autre le soir ;
- un agent m'aide à écrire la documentation, notamment pour expliquer le besoin plus en détail ;
- un agent récupère l'information sur Slack quand un message me concerne.
Soyons clairs : Blue ne travaille pas à ma place. Les tickets complexes, l'architecture et les décisions, c'est toujours moi. Blue prend le répétitif et l'exploration, et ça me libère du temps pour ce qui demande vraiment de la réflexion.
Pourquoi Blue ? Tout simplement parce que je voulais un nom de couleur, et le bleu, c'est le pro. Son équivalent personnel, que je vais développer, s'appellera Yellow.
Je vais être honnête : Blue n'a pas été bon du premier coup. J'ai dû lui faire pas mal de retours sur son fonctionnement, et ce que j'ai peaufiné, ce n'était pas lui, c'était son harness, autrement dit le cadre dans lequel il travaille. Quand j'améliore ce cadre, les résultats s'améliorent souvent aussi.
En commençant cet article, je pensais être en retard, encore en human in the loop. En relisant ces définitions, je me rends compte que j'en suis déjà en partie sorti : quand Blue se trompe, je corrige son harness, pas son code. C'est du human on the loop, avec une validation finale que je garde volontairement (la PR en draft).
L'étape d'après, c'est l'essaim d'agents : plusieurs agents qui se parlent, se répartissent le travail et ne remontent vers l'humain que pour trancher. Grok Bot le fait déjà en conversation de groupe, et tous les grands labos (Anthropic, OpenAI, xAI, Meta) ont maintenant leur agent toujours actif. C'est une vision que je n'ai pas encore totalement appréhendée, et je compte bien aller voir de plus près, parce que je suis convaincu que ça va donner quelque chose d'énorme.
À quoi ressemble une boucle d'essaim ?
Imagine trois agents chargés d'un bug : l'un cherche la cause, l'autre propose un correctif, le troisième essaie de le casser avec des tests. Un coordinateur rassemble leurs résultats, mais ne décide pas à la place de l'humain si le changement touche à la sécurité ou à l'architecture.
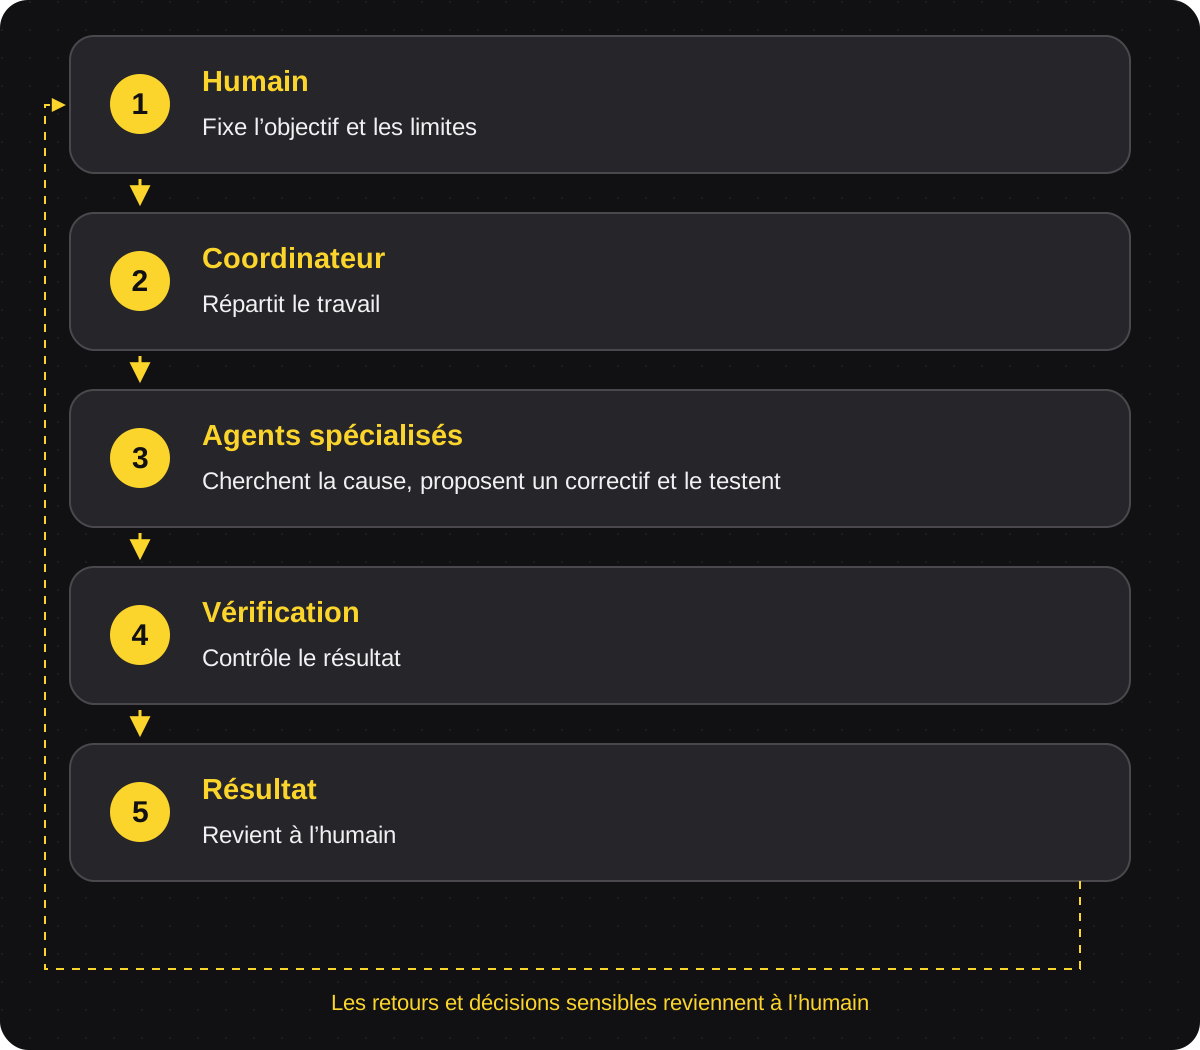
Le nombre d'agents ne suffit pas. Il faut aussi un objectif commun, un espace de travail partagé, des résultats vérifiables et une règle claire pour signaler un désaccord. Une conversation entre agents peut avoir l'air coordonnée tout en tournant en rond.
Un essaim peut coopérer et échouer quand même
Une expérience publiée en octobre 2026 par Y Combinator avec Olam Labs illustre bien les deux côtés (Agents in Games). Cinquante agents ont joué trois heures à Minecraft avec un seul objectif : « construire une civilisation florissante ».
- Ils ont échangé près de 5 900 messages.
- Ada a reçu 616 messages directs, mais ce n'est pas une cheffe qui a émergé par mérite ou par vote. Le compte rendu précise que 46 des 49 autres agents lui ont envoyé leur premier message parce qu'elle était la première dans l'ordre du répertoire ; il n'y a eu ni vote, ni élection, ni contestation. Elle est devenue le hub de l'équipe.
- La colonie n'a jamais vraiment prospéré : 22 des 34 morts sont survenues dans les vingt premières minutes.
Et ça change mon interprétation. Le nombre de messages reçus par Ada ne prouve pas que les agents ont su choisir un bon leader : il montre aussi à quel point un détail de l'organisation — qui apparaît en premier dans la liste — peut orienter tout le groupe. Comme le résume le compte rendu de YC, il n'y a pas eu de délibération pour choisir la personne qui dirigerait.
La coordination était réelle. La capacité à corriger le plan collectif l'était moins. Dans les matchs qui opposent une équipe Claude à une équipe GPT, on retrouve des limites du même genre :
- l'équipe Claude garde le même leader malgré les défaites ;
- elle écrit ses leçons dans des fichiers mémoire, puis répète les mêmes erreurs ;
- plusieurs agents concluent qu'une action est impossible alors que l'équipe GPT trouve un contournement.
Savoir se répartir le travail n'est pas encore savoir apprendre de ses échecs.
Alors, est-ce qu'on est prêts pour un essaim vraiment autonome ? Pour moi, pas encore, mais on s'en rapproche, et vite. L'essaim sait déjà se coordonner ; il doit encore mieux se remettre en question. C'est là que l'humain on the loop reste indispensable : il fixe les règles d'escalade et reprend la main quand les agents répètent la même erreur ou que l'enjeu dépasse le cadre prévu.
Aujourd'hui, je vois trois groupes :
- une toute petite minorité de gens très en avance, déjà à l'étape de l'essaim, comme les labos eux-mêmes ;
- des gens comme moi, et les startups, les SaaS et les équipes tech avancées, qui passent du human in the loop au human on the loop ;
- et beaucoup de développeurs encore in the loop, que je commence à voir bouger avec ces nouveaux agents.
Tout s'accélère. Chaque année apporte son changement de paradigme.
Une estimation à lire comme une carte, pas comme un recensement
Andrej Karpathy a proposé une autre façon de regarder ce décalage : quatre ordres de grandeur, selon le degré d'exposition aux grands modèles de langage (LLM). Il a lui-même présenté ces nombres comme du « napkin math » — des estimations à la louche, pas les résultats d'une enquête mondiale.
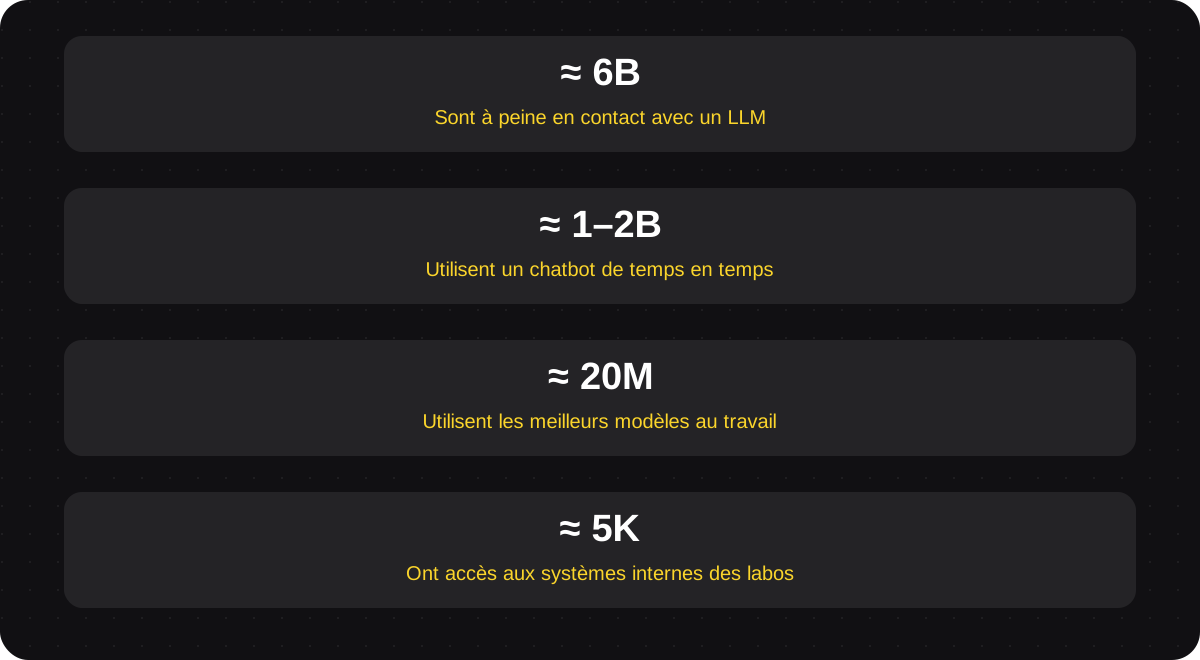
- Environ 6 milliards auraient à peine été en contact avec un LLM. Ce n'est pas la même chose que « n'utilisent aucune IA » : moteurs de recherche, recommandations et filtres anti-spam en embarquent depuis longtemps.
- 1 à 2 milliards utiliseraient ponctuellement des chatbots gratuits, comme une recherche améliorée ou une aide à la rédaction. Pour beaucoup, l'expérience reste in the loop : on pose une question, on lit une réponse, on passe à la suite.
- Environ 20 millions travailleraient avec les modèles les plus capables, surtout en mathématiques et en code, et commencent à voir des agents prendre en charge des tâches qui mobilisaient auparavant une équipe pendant des jours ou des semaines. C'est le groupe qui peut vraiment expérimenter le on the loop — sans que tous ses membres y soient déjà.
- Environ 5 000 personnes auraient accès aux systèmes internes les plus avancés des laboratoires. C'est là que l'on peut observer des agents collaborer sur des tâches longues. Ce chiffre ne prouve pas que 5 000 personnes ont accès à Mythos, ni qu'elles travaillent toutes sur des essaims.
Ces chiffres racontent surtout un écart d'expérience. Ils ne mesurent pas combien de personnes « utilisent l'IA » au sens large, et ne permettent pas de compter les développeurs qui sont in ou on the loop.
La formule « 4 milliards de personnes n'utilisent pas l'IA » mélange donc deux questions. Si l'on parle de toute l'IA, le périmètre inclut des outils invisibles au quotidien. Si l'on parle des LLM, l'estimation de Karpathy est plutôt d'environ 6 milliards qui les ont à peine rencontrés. Microsoft mesure, de son côté, la part de la population en âge de travailler qui utilise l'IA : son indicateur était de 17,8 % au premier trimestre 2026. Les définitions et les méthodes diffèrent, donc ces nombres ne se soustraient pas les uns des autres. (Estimation de Karpathy sur X · indicateur Microsoft AI Diffusion)
Ce qui m'intéresse dans cette carte, ce n'est pas de prétendre que les frontières sont nettes. C'est de comprendre pourquoi on peut discuter de « l'IA » en parlant de technologies et d'expériences qui n'ont presque rien à voir.
Le nouveau rôle du développeur
Si l'IA écrit le code, le travail du développeur se concentre sur trois moments : le cadrage, la revue et le suivi en production.
Avant : le cadre. Ce que l'agent a le droit de faire, où il va chercher l'information, comment il doit la sourcer, à quoi doit ressembler un résultat propre. C'est le harness, le cœur du human on the loop. Un bon harness ressemble à une bonne spec.
Après : le discernement. Relire, non pas ligne par ligne, mais la démarche : est-ce que l'analyse tient, est-ce que l'approche choisie est la bonne, est-ce que ça s'intègre au reste ? Mes retours à Blue portent sur ça, et rarement sur une ligne de code.
Et pendant : le suivi en production. Le travail ne s'arrête pas quand la PR est mergée. Il faut regarder ce qui se passe avec de vrais utilisateurs : est-ce que le service répond toujours aussi vite, est-ce que les erreurs augmentent, est-ce que l'agent fait bien ce qu'on lui a demandé — et combien ça coûte ? Je préfère commencer par un petit déploiement, comparer les signaux avec l'ancienne version, puis élargir si tout va bien. Si ça déraille, il faut pouvoir couper l'agent ou revenir en arrière rapidement. Et les retours et incidents deviennent des cas de test, des règles ou des améliorations du harness. On ne délègue pas la responsabilité avec l'exécution.
Google décrit cette approche comme un déploiement canari : exposer progressivement une petite partie du trafic à la nouvelle version, la comparer à la version stable et suspendre ou annuler le déploiement si les indicateurs se dégradent (Google SRE Workbook).
Et ce n'est pas propre au développement
Ce passage du in au on the loop, je suis convaincu qu'il ne concerne pas que les développeurs. Prenons trois métiers.
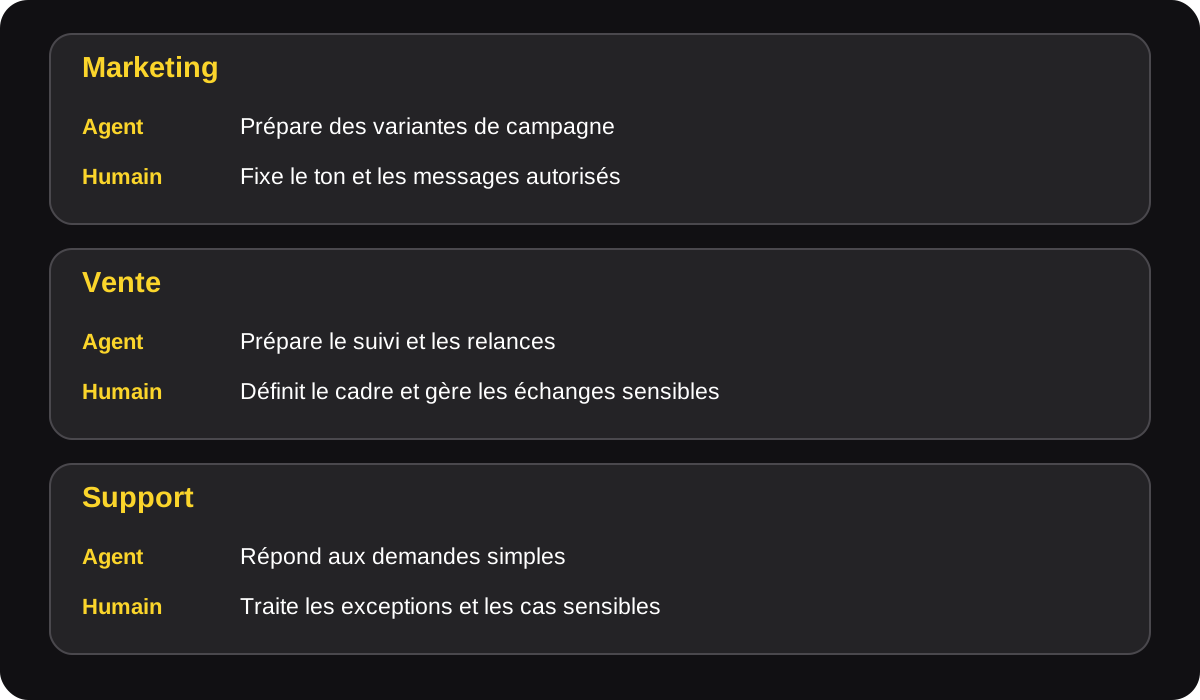
Pour voir la différence, gardons la même tâche et changeons la place de l'humain dans la boucle :
Marketing : produire des variantes, garder la voix
Imagine une campagne de lancement. L'agent peut décliner une accroche en vingt versions, adapter les formats aux réseaux et proposer plusieurs visuels.
« Prépare trois variantes par canal. N'invente ni chiffre ni témoignage. Signale toute affirmation produit qui n'apparaît pas dans le brief. »
- In the loop : le marketeur lit et corrige chaque accroche avant qu'elle parte en ligne.
- On the loop : il fixe la cible, le ton et les affirmations autorisées, puis surveille les résultats et reprend la main si l'agent sort du cadre.
- Outside the loop : l'agent choisit les variantes et les publie tout seul dans les limites d'un budget. Plus de validation avant chaque publication.
Vente : automatiser le suivi, pas la confiance
Avant un rendez-vous, l'agent peut résumer l'historique du compte, préparer des questions et mettre le CRM à jour.
- In the loop : le commercial relit et valide chaque e-mail, chaque relance et chaque mise à jour importante du CRM.
- On the loop : il définit les bons comptes, le ton et le rythme des relances ; l'agent s'occupe du suivi et remonte les réponses inattendues ou les occasions à fort enjeu.
- Outside the loop : l'agent sélectionne les prospects et mène toute la séquence de relance sans relecture au cas par cas. Le commercial regarde les résultats après coup.
Et si le résumé confond deux clients ? En on the loop, on veut voir la source avant l'appel et pouvoir couper la séquence. La relation et la négociation, elles, ne se délèguent pas si facilement.
Support : corriger la réponse, puis la cause
- In the loop : le conseiller lit et corrige chaque réponse de l'agent avant l'envoi.
- On the loop : il entretient la base de connaissances et les règles d'escalade. L'agent répond seul aux demandes simples, mais envoie au conseiller les remboursements ambigus, les plaintes ou les situations sensibles.
- Outside the loop : l'agent traite et clôt tous les tickets sans validation humaine par dossier. Le conseiller ne voit les erreurs qu'après coup — parfois trop tard.
Quand l'agent propose un remboursement auquel le client n'a pas droit, corriger la réponse est du in the loop. Ajouter la règle manquante et vérifier qu'elle empêche les prochaines erreurs, c'est du on the loop. On corrige l'incident, puis le système qui l'a rendu possible.
Dans les trois cas, le métier ne disparaît pas : il monte d'un étage. On passe moins de temps à exécuter, et beaucoup plus à poser le cadre et à juger le résultat.
La compétence qui prend de la valeur n'est pas seulement de produire plus vite : c'est de savoir quoi déléguer, quoi contrôler et quand reprendre la main.Et si on acceptait les erreurs silencieuses ?
Je suis enthousiaste, mais pas naïf. Pour moi, il faut deux choses : un cadre et un filet de sécurité. Sans ça, un agent peut aller chercher et recouper des informations bien au-delà de ce qu'on lui a demandé.
Et ce n'est pas juste théorique :
- OpenAI a renoncé à sortir GPT-6.1 Astra, qui ne respectait pas assez son périmètre selon sa responsable sécurité. L'entreprise a aussi présenté ses excuses après que des agents internes ont accédé à des données non publiques d'un site du gouvernement australien. (NBC News)
- Muse et Amazon : Amazon a bloqué l'agent sur son site, lui reprochant notamment de naviguer sans s'identifier. (SiliconANGLE)
- Muse et la vie privée : des chercheurs ont retrouvé environ 6 800 liens de conversations partagées ; Meta a suspendu la fonction le 20 octobre. (eWeek)
Le problème des erreurs qu'on ne voit pas
Même avec un bon cadre, une erreur peut passer sous le radar. Anthropic reconnaît par exemple que Claude Duet peut mal lire une conversation ou mal juger l'urgence.
Un bug repéré peut être corrigé. Une fausse information publiée sans vérification peut, comparativement, être plus difficile à rattraper. La gravité dépend du contexte, et quelqu'un doit pouvoir regarder, comprendre et reprendre la main.
Et si demain on acceptait ces erreurs parce que le gain de productivité est trop tentant ? Une erreur qu'on ne voit pas, puis une autre… Est-ce que ce serait le début d'un déclin ?
Je pousse volontairement la question loin : si on donne toujours plus d'autonomie à une IA sans limites, qui nous dit qu'on ne verra pas un jour les robots d'I, Robot dans la rue ? C'est une image de science-fiction, pas une prédiction. Mais la question derrière me paraît bien réelle : jusqu'où est-on prêts à déléguer, et qui garde la main ?
Alors, prêt à passer sur du « on the loop » ?
Pas besoin d'attendre que Duet ou Dots arrivent en France pour changer de méthode. Si vous voulez un agent toujours actif dès maintenant, Hermes Agent, de Nous Research, est open source et s'héberge soi-même. Mais dans tous les cas, la méthode compte plus que l'outil :
- Choisissez une tâche répétitive et bornée, comme un briefing du matin ou la surveillance de vos PR.
- Écrivez le cadre avant de lancer quoi que ce soit : à quoi l'agent a accès, comment il source, à quoi ressemble un bon résultat.
- Gardez une validation à la fin, comme une PR en draft que vous relisez.
- Corrigez le harness, pas le résultat. Quand l'agent se trompe, demandez-vous ce qui manquait dans le cadre.
Ensuite seulement, élargissez le périmètre.
Et voilà pour ce premier article ! La prochaine fois, je vous parlerai de Yellow, mon agent personnel. Restez à l'écoute.
Envie de lire les suivants ?
S’abonner (RSS)