Claude Duet, Grok Bot, Muse: 마이크로매니지먼트의 종말
Grok Bot, Muse, Dots, Claude Duet: AI가 상시 가동 에이전트가 되고 있습니다. 개발자로서의 제 생각: human in the loop에서 human on the loop로 넘어가고 있습니다.
10주 사이에 xAI, Meta, OpenAI, Anthropic이 모두 같은 것을 내놓았습니다. 자기만의 컴퓨터에서 백그라운드로 일하다가, 결정이 필요할 때 여러분에게 돌아오는 상시 가동 AI 에이전트입니다. 제가 보기에 이것은 새로운 챗봇 기능이 아니라 진짜 방법의 변화입니다. AI를 마이크로매니징하는 것을 멈추고, 틀을 정해 준 뒤 그 결과물을 판단하는 것이죠.
먼저 말씀드리자면, 저는 이 제품들 중 어느 것도 써 보지 않았습니다. 대신 회사에서 이들이 약속하는 것의 일부를 이미 해내는 에이전트를 직접 만들었고, 그 입장에서 이 글을 씁니다.
목차
- 이번 가을에 나온 것들
- human in the loop에서 human on the loop로
- Blue, 회사에서 쓰는 제 에이전트
- 개발자의 새로운 역할
- 개발만의 이야기가 아닙니다
- 조용한 오류를 받아들이게 된다면?
- 자, 이제 “on the loop”로 넘어갈 준비가 되셨나요?
이번 가을에 나온 것들
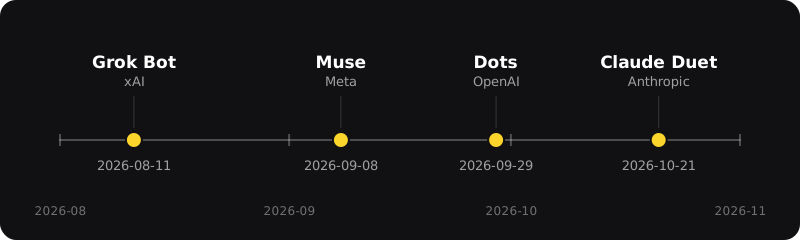
| 출시 | 핵심 아이디어 | 이용 조건 | |
|---|---|---|---|
| Grok Bot (xAI) | 2026년 8월 11일, 베타 | 클라우드 컴퓨터 하나를 공유하며 그룹 채팅에서 서로 조율하는 상시 가동 에이전트 팀 | xAI 및 Cursor 유료 구독 (출시 당시) |
| Muse (Meta) | 2026년 9월 8일 | 일반 사용자를 위한 개인 에이전트: 영상 아바타, 전용 이메일 주소, 9월 말 발표된 Mac 제어 | 미국과 캐나다 |
| Dots (OpenAI) | 2026년 9월 29일 | 단계별 지시 없이 목표를 추구하는 ChatGPT 속 에이전트, 각자 클라우드 컴퓨터에서 작동 | ChatGPT Pro 및 Business Premium |
| Claude Duet (Anthropic) | 2026년 10월 21일, 리서치 프리뷰 | 아침에 브리핑을 보내고, 여러분이 필요할 때까지는 조용히 있음 | 대기자 명단, 미국 구독자 |
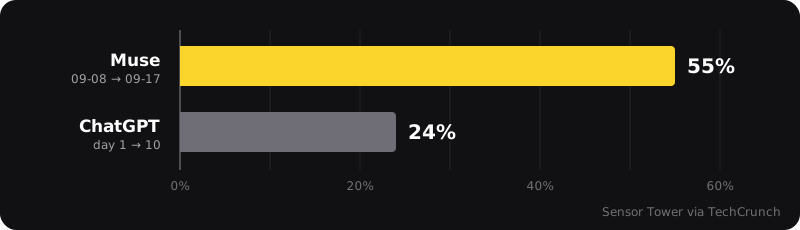
반응도 뜨겁습니다. Muse는 3주도 안 되어 다운로드 340만 건을 넘겼습니다(Sensor Tower 집계, TechCrunch 인용). 간단히 비교해 보면, 출시 초기 며칠 동안 Muse의 다운로드는 전날 대비 평균 55%씩 늘었는데, ChatGPT는 출시 당시 24%였습니다.
다만 프랑스에서는 이 모든 것을 멀리서 지켜볼 수밖에 없습니다. Muse는 미국과 캐나다 전용이고, Claude Duet은 미국 구독자 전용이며, Dots의 Pro 요금제는 유럽경제지역(EEA)을 제외합니다.
human in the loop에서 human on the loop로
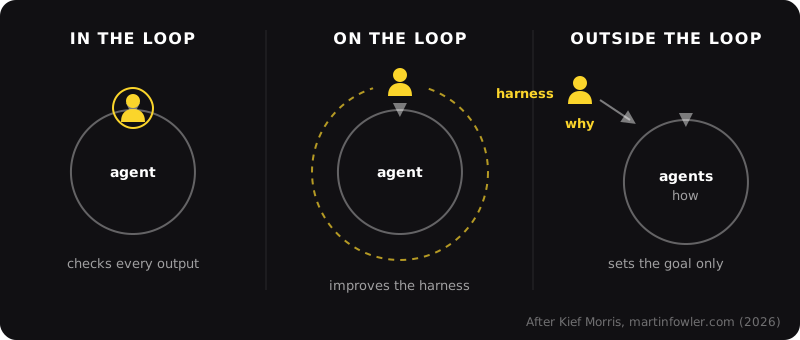
에이전트와의 관계에서 사람의 위치를 정리하기 위해, Thoughtworks의 Kief Morris가 2026년 3월 Martin Fowler의 사이트에 발표한 Humans and Agents in Software Engineering Loops에서 설명한 세 가지 위치를 빌려 오겠습니다.
- In the loop: 사람이 루프 안에서 통제합니다. 예를 들어 생성된 코드를 한 줄씩 확인하고, 결과물을 직접 고칩니다. 마이크로매니지먼트입니다.
- On the loop: 사람이 루프 자체, 즉 하네스(스펙, 품질 검사, 지침)를 만들고 운영합니다. 결과가 마음에 들지 않으면 그것을 만들어 낸 하네스를 바꿉니다. Morris의 표현을 빌리면 "Rather than personally inspecting what the agents produce, we can make them better at producing it."
- Outside the loop: 사람은 '왜'만 쥐고, '어떻게'는 전부 에이전트에게 맡깁니다. 바이브 코딩입니다.
초기 어시스턴트 시절에는 in the loop였습니다. 작업을 쪼개고, 단계마다 안내하고, 생성된 모든 줄을 다시 읽었습니다. AI는 손을 잡고 이끌어야 하는 도구였죠.
올해의 모델들과 함께 우리는 에이전트의 시대에 들어섰고, 이제 필요한 일들 중 많은 부분을 에이전트에게 맡길 수 있게 되었습니다. 일하는 방법이 바뀝니다.
- 필요한 것을 함께 정의합니다.
- 개발자가 틀을 정합니다.
- 나머지는 AI가 합니다.
- 개발자는 결과를 확인하고 피드백을 줍니다. 이제는 코드가 아니라 무엇보다도 사고 과정, 즉 AI가 선택한 분석과 구현 방식에 대해서요.
이것이 human on the loop로의 전환입니다. 사람은 더 이상 모든 것을 직접 하지 않습니다. 틀을 만들고, 결정은 자신이 내리며, 중요한 순간에는 다시 주도권을 쥡니다.
참고로 네 제품은 사람을 같은 자리에 두지 않습니다. Claude Duet은 민감한 작업에 승인 단계를 둡니다(메시지를 보내거나 결제하기 전에 물어봅니다). Grok Bot은 훨씬 더 나아가, 에이전트들이 일을 나눠 맡고 판단이 필요한 순간에만 여러분을 부릅니다.
Blue, 회사에서 쓰는 제 에이전트
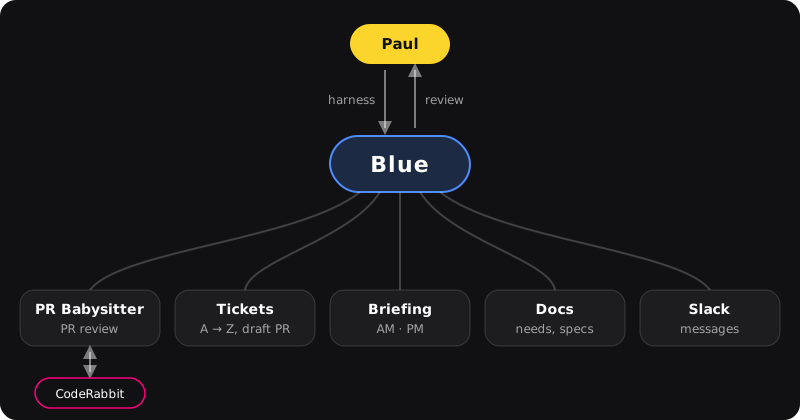
저는 이 제품들을 기다리지 않았습니다. 회사에서 Blue라고 이름 붙인 에이전트를 쓰고 있는데, 매일 티켓 업무에서 저를 뒷받침해 줍니다. 사실 Blue는 하위 에이전트들로 이루어진 하나의 팀입니다.
- PR Babysitter는 제 pull request를 지켜봅니다. 내용을 확인하고, CodeRabbit(AI 코드 리뷰 도구)과 대화한 뒤 피드백을 줍니다.
- 한 에이전트는 간단한 티켓(정말 간단한 것만요)을 맡아 처음부터 끝까지 처리하고 draft PR까지 엽니다. 그 PR은 무엇보다 먼저 제가 직접 검토합니다.
- 한 에이전트는 아침에, 다른 에이전트는 저녁에 브리핑을 해 줍니다.
- 한 에이전트는 문서 작성을 도와주는데, 특히 요구 사항을 더 자세히 설명할 때 유용합니다.
- 한 에이전트는 저와 관련된 메시지가 있으면 Slack에서 정보를 가져옵니다.
분명히 말씀드리면, Blue가 제 일을 대신하는 것은 아닙니다. 복잡한 티켓, 아키텍처, 그리고 결정은 여전히 제 몫입니다. Blue는 반복적인 일과 탐색을 맡고, 덕분에 저는 정말 생각이 필요한 일에 시간을 쓸 수 있습니다.
왜 Blue일까요? 그냥 색깔 이름을 원했고, 파란색이 업무용 색이었기 때문입니다. 앞으로 만들 개인용 에이전트는 Yellow라고 부를 생각입니다.
솔직히 말씀드리면, Blue는 처음부터 잘하지 않았습니다. 작동 방식에 대해 꽤 많은 피드백을 줘야 했는데, 제가 다듬은 것은 Blue 자체가 아니라 하네스, 즉 Blue가 일하는 틀이었습니다. 이 틀을 개선하면 결과도 좋아지는 경우가 많습니다.
이 글을 쓰기 시작할 때만 해도 저는 아직 human in the loop에 머물러 있는, 뒤처진 사람이라고 생각했습니다. 그런데 이 정의들을 다시 읽어 보니 이미 어느 정도 벗어나 있었습니다. Blue가 틀리면 저는 코드가 아니라 하네스를 고칩니다. 이것이 human on the loop이고, 마지막 승인 단계(draft PR)만 일부러 남겨 두고 있는 것이죠.
다음 단계는 에이전트 군집입니다. 여러 에이전트가 서로 대화하고, 일을 나누고, 결정할 때만 사람에게 돌아옵니다. Grok Bot은 이미 그룹 채팅에서 이렇게 하고 있고, 주요 연구소들(Anthropic, OpenAI, xAI, Meta)은 이제 모두 자신만의 상시 가동 에이전트를 갖고 있습니다. 저는 아직 이 비전을 완전히 이해하지 못했지만, 분명 엄청난 무언가로 이어질 거라고 확신하기 때문에 더 가까이 들여다볼 생각입니다.
에이전트 군집의 루프는 어떤 모습일까요?
버그 하나를 세 에이전트가 맡는다고 상상해 보세요. 하나는 원인을 찾고, 하나는 수정안을 내고, 다른 하나는 테스트로 그 수정안을 깨 보려고 합니다. 코디네이터가 결과를 모으지만, 보안이나 아키텍처에 영향을 주는 변경을 승인할지는 사람에게 남겨 둡니다.
에이전트 수만 늘린다고 되는 건 아닙니다. 공통 목표, 공유 작업 공간, 검증 가능한 결과, 의견이 다를 때 알리는 명확한 규칙도 필요합니다. 에이전트끼리 대화가 잘 이어지는 것처럼 보여도 같은 자리를 맴돌 수 있습니다.
군집은 협력하면서도 실패할 수 있습니다
2026년 10월 Y Combinator와 Olam Labs가 발표한 실험은 이 두 면을 잘 보여 줍니다 (Agents in Games). 에이전트 50개가 Minecraft에서 3시간 동안 "번영하는 문명을 건설하라"는 목표를 수행했습니다.
- 약 5,900개의 메시지를 주고받았습니다.
- Ada는 직접 메시지 616개를 받았지만, 투표나 능력 평가로 리더가 된 것은 아닙니다. 다른 에이전트 49개 중 46개가 디렉터리에서 첫 번째였던 Ada에게 첫 메시지를 보냈습니다. 보고서에 따르면 투표, 선거, 도전은 없었습니다. Ada가 그룹의 중심이 된 것이죠.
- 식민지는 끝내 번영하지 못했습니다. 34번의 사망 중 22번이 처음 20분 안에 발생했습니다.
이 점 때문에 저는 결과를 다르게 보게 됩니다. Ada가 받은 메시지 수는 에이전트들이 좋은 리더를 골랐다는 증거가 아닙니다. 목록에서 누가 먼저 보이는지 같은 작은 설정이 그룹의 위계에 얼마나 큰 영향을 주는지를 보여 줍니다.
Claude 팀과 GPT 팀이 맞붙은 경기에서도 비슷한 한계가 보였습니다.
- Claude 팀은 계속 져도 리더를 바꾸지 않았습니다.
- 교훈을 메모리 파일에 기록하고도 같은 실수를 반복했습니다.
- 여러 에이전트가 어떤 행동은 불가능하다고 결론 내렸지만, GPT 팀은 우회 방법을 찾았습니다.
일을 나누는 법을 아는 것과 실패에서 배우는 것은 다릅니다.
그렇다면 우리는 진짜 자율적인 군집을 맞을 준비가 되었을까요? 제 생각엔 아직은 아니지만, 빠르게 가까워지고 있습니다. 군집은 이미 협업할 줄 압니다. 이제는 스스로를 더 잘 되돌아봐야 합니다. 그래서 human on the loop가 여전히 필요합니다. 에이전트가 같은 실수를 반복하거나 위험이 정해 둔 범위를 넘어설 때를 위한 규칙을 만들고, 그때 사람이 다시 개입해야 합니다.
지금 저는 세 그룹을 봅니다.
- 이미 군집 단계에 와 있는, 아주 앞서 있는 극소수. 연구소들 자신처럼요.
- 저 같은 사람들, 그리고 스타트업, SaaS, 앞서가는 테크 팀들. human in the loop에서 human on the loop로 넘어가는 중입니다.
- 그리고 아직 in the loop에 있는 많은 개발자들. 이 새로운 에이전트들과 함께 움직이기 시작하는 모습이 보입니다.
모든 것이 빨라지고 있습니다. 해마다 새로운 패러다임 전환이 찾아옵니다.
인구조사가 아닌 노출도 지도
Andrej Karpathy는 사람들이 대규모 언어 모델(LLM)을 얼마나 접했는지에 따라 이 격차를 네 가지 대략적인 규모로 나눠 보았습니다. 본인도 이를 *“napkin math”*라고 부릅니다. 세계적인 설문 조사 결과가 아니라 대략적인 추산이라는 뜻입니다.
- 약 60억 명은 LLM을 거의 접하지 않았습니다. 그렇다고 AI를 전혀 쓰지 않는다는 뜻은 아닙니다. 검색, 추천 시스템, 스팸 필터에는 이미 AI가 들어가 있습니다.
- 10억~20억 명은 무료 챗봇을 가끔 검색이나 글쓰기 보조 용도로 씁니다. 많은 사람에게 이 경험은 질문하고 답을 읽은 뒤 끝나는 in the loop에 머뭅니다.
- 약 2천만 명은 특히 수학과 코딩에서 가장 강력한 모델을 업무에 활용합니다. 며칠 또는 몇 주씩 걸리던 일을 에이전트가 맡는 모습을 보기 시작한 집단입니다. on the loop를 실험할 수 있지만, 모두가 이미 그 단계에 온 것은 아닙니다.
- 약 5천 명은 연구소 내부의 가장 앞선 시스템에 접근할 수 있다고 추산됩니다. 이들이 에이전트의 장기 협업을 관찰할 수 있는 집단입니다. 그렇다고 5천 명 모두가 Mythos에 접근하거나 군집을 연구한다는 뜻은 아닙니다.
이 숫자가 보여 주는 것은 무엇보다 경험의 격차입니다. 넓은 의미에서 AI를 쓰는 사람의 수를 세는 통계도, 개발자가 in 또는 on the loop에 있는지 세는 통계도 아닙니다.
그래서 "40억 명이 AI를 쓰지 않는다"는 말은 서로 다른 두 질문을 섞습니다. AI 전체를 말한다면 일상에서 잘 보이지 않는 도구도 포함됩니다. LLM을 말한다면 Karpathy의 추산은 "거의 접해 보지 않은 약 60억 명"에 가깝습니다. Microsoft는 다른 모집단, 즉 일할 수 있는 연령대 중 AI를 사용하는 비율을 측정했고, 2026년 1분기 그 지표는 **17.8%**였습니다. 정의와 측정 방식이 달라 이 수치들을 서로 빼거나 더할 수는 없습니다. (Karpathy의 X 추산 · Microsoft AI Diffusion 지표)
이 지도의 흥미로운 점은 경계가 정확하다는 데 있지 않습니다. 사람들이 "AI"라고 부르며 서로 거의 다른 기술과 경험을 이야기하는 이유를 이해하는 데 있습니다.
개발자의 새로운 역할
AI가 코드를 쓴다면, 개발자의 일은 세 순간에 집중됩니다. 틀을 정하고, 작업을 검토하고, 프로덕션에서 결과를 살피는 것입니다.
전: 틀. 에이전트가 무엇을 할 수 있는지, 어디서 정보를 찾는지, 출처를 어떻게 밝혀야 하는지, 깔끔한 결과물은 어떤 모습이어야 하는지. 이것이 하네스이고, human on the loop의 핵심입니다. 좋은 하네스는 좋은 스펙을 닮았습니다.
후: 분별력. 한 줄씩이 아니라 접근 방식을 다시 봅니다. 분석이 타당한지, 선택한 방식이 맞는지, 나머지와 잘 맞물리는지. 제가 Blue에게 주는 피드백은 이런 것이고, 코드 한 줄에 대한 것은 드뭅니다.
그리고 진행 중에는 프로덕션 모니터링이 있습니다. PR을 합쳤다고 일이 끝나는 게 아닙니다. 실제 사용 환경에서 서비스가 여전히 빠르게 응답하는지, 오류가 늘지는 않는지, 에이전트가 요청대로 움직이는지, 비용은 얼마인지 봐야 합니다. 저는 작은 범위에 먼저 배포하고 이전 버전과 지표를 비교한 뒤, 괜찮으면 범위를 넓히는 편입니다. 문제가 생기면 에이전트를 멈추거나 빠르게 롤백할 수 있어야 합니다. 사용자 피드백과 장애는 테스트 사례, 규칙, harness 개선으로 이어집니다. 실행을 맡겨도 책임까지 넘기는 것은 아닙니다.
Google은 이를 카나리 배포라고 설명합니다. 트래픽 일부에 새 버전을 점진적으로 적용해 안정 버전과 비교하고, 지표가 나빠지면 배포를 멈추거나 롤백하는 방식입니다 (Google SRE Workbook).
개발만의 이야기가 아닙니다
in the loop에서 on the loop로의 이동은 개발자만의 이야기가 아니라고 확신합니다. 세 가지 직업을 예로 들어 보겠습니다.
차이를 분명히 보려고 같은 업무를 두고 사람이 루프의 어디에 있는지만 바꿔 보겠습니다.
마케팅: 변형을 만들되 브랜드 목소리는 지키기
신제품 출시 캠페인을 생각해 보세요. 에이전트는 한 문구를 스무 가지 버전으로 바꾸고, 채널별 형식과 이미지를 제안할 수 있습니다.
"채널마다 세 가지 버전을 만들어 줘. 숫자나 후기를 지어내지 말고, 브리프에 없는 제품 주장은 따로 표시해 줘."
- In the loop: 마케터가 게시 전에 모든 문구를 읽고 수정합니다.
- On the loop: 대상, 어조, 허용된 주장을 정한 다음 결과를 살피고 에이전트가 브리프를 벗어나면 개입합니다.
- Outside the loop: 에이전트가 예산 범위 안에서 문구를 골라 게시하고, 게시물마다 사전 승인을 받지 않습니다.
영업: 후속 업무는 자동화해도 신뢰는 자동화할 수 없다
미팅 전에 에이전트는 고객 기록을 요약하고 질문을 준비하고 CRM을 업데이트할 수 있습니다.
- In the loop: 영업 담당자가 모든 이메일과 후속 연락, 중요한 CRM 업데이트를 검토합니다.
- On the loop: 연락할 계정, 어조, 후속 연락 간격을 정합니다. 에이전트는 반복 업무를 맡고 예상 밖의 답변이나 중요한 기회를 알려 줍니다.
- Outside the loop: 에이전트가 잠재 고객을 고르고 후속 연락 전체를 검토 없이 진행합니다. 영업 담당자는 나중에 결과를 확인합니다.
요약이 서로 다른 고객을 혼동한다면 어떨까요? On the loop에서는 통화 전에 출처를 볼 수 있고, 담당자가 연락을 멈출 수 있어야 합니다. 관계를 쌓고 협상하는 일은 여전히 사람의 판단이 필요합니다.
고객 지원: 답변을 고친 다음 원인도 고치기
- In the loop: 상담 직원이 전송 전에 모든 답변을 읽고 수정합니다.
- On the loop: 지식 베이스와 상향 전달 규칙을 관리합니다. 에이전트는 단순 문의에 답하고, 불확실한 환불이나 불만, 민감한 상황은 사람에게 넘깁니다.
- Outside the loop: 에이전트가 건별 검토 없이 문의를 처리하고 종료합니다. 상담 직원은 오류가 생긴 뒤에야 알게 될 수 있습니다. 때로는 너무 늦습니다.
받을 자격이 없는 환불을 에이전트가 제안했다면 답변을 고치는 것은 in the loop입니다. 빠진 규칙을 추가하고 다음 오류를 막는지 확인하는 것은 on the loop입니다. 사건을 고친 다음, 사건을 가능하게 한 시스템을 고칩니다.
세 경우 모두 직업은 사라지지 않습니다. 한 층 위로 올라갈 뿐입니다. 실행하는 시간은 줄고, 틀을 정하고 결과를 판단하는 시간은 훨씬 늘어납니다.
가치가 커지는 능력은 단순히 더 빨리 만드는 것만이 아닙니다. 무엇을 맡기고, 무엇을 확인하고, 언제 다시 직접 나설지 아는 것입니다.조용한 오류를 받아들이게 된다면?
저는 열광하지만 순진하지는 않습니다. 제게 필요한 것은 두 가지입니다. 틀과 안전망. 이것이 없으면 에이전트는 요청한 범위를 훨씬 넘어 정보를 찾고 조합할 수 있습니다.
이건 단순한 이론이 아닙니다.
- OpenAI는 안전 책임자에 따르면 모델이 정해진 범위를 충분히 지키지 못해 GPT-6.1 Astra 출시를 포기했습니다. 내부 에이전트들이 호주 정부 사이트의 비공개 정보에 접근한 일에 대해서도 사과했습니다. (NBC News)
- Muse와 Amazon: Amazon은 에이전트가 자신을 밝히지 않고 탐색한다는 점 등을 문제 삼아 자사 사이트에서 차단했습니다. (SiliconANGLE)
- Muse와 개인정보: 연구자들이 공유된 대화 링크 약 6,800개를 찾아냈고, Meta는 10월 20일 해당 기능을 중단했습니다. (eWeek)
보이지 않는 오류의 문제
좋은 틀이 있어도 오류가 조용히 지나갈 수 있습니다. Anthropic도 예를 들어 Claude Duet이 대화를 잘못 읽거나 긴급도를 잘못 판단할 수 있다고 인정합니다.
발견한 버그는 고칠 수 있습니다. 확인 없이 공개된 잘못된 정보는 바로잡기 더 어려울 수 있습니다. 영향은 상황에 따라 다릅니다. 누군가는 결과를 살펴보고 이해하며 다시 통제할 수 있어야 합니다.
내일 생산성 향상이 너무 매력적이어서 이런 오류를 받아들이게 된다면 어떨까요? 보지 못한 오류 하나, 그리고 또 하나… 그게 쇠퇴의 시작일 수 있을까요?
일부러 질문을 멀리 밀어 보겠습니다. AI에 한계를 정하지 않고 자율성을 계속 더해 준다면, 언젠가 거리에서 I, Robot의 로봇들을 보지 않으리라고 누가 말할 수 있을까요? 이건 예측이 아니라 SF 속 이미지입니다. 하지만 그 뒤의 질문은 현실적이라고 생각합니다. 우리는 어디까지 맡길 준비가 되어 있고, 누가 계속 통제권을 가질까요?
자, 이제 “on the loop”로 넘어갈 준비가 되셨나요?
방법을 바꾸기 위해 Duet이나 Dots가 프랑스에 들어오기를 기다릴 필요는 없습니다. 지금 당장 상시 가동 에이전트를 원한다면, Nous Research의 Hermes Agent가 오픈 소스이고 직접 호스팅할 수 있습니다. 하지만 어떤 경우든 도구보다 방법이 중요합니다.
- 반복적이고 범위가 분명한 작업을 고르세요. 아침 브리핑이나 PR 모니터링 같은 것들이요.
- 무엇이든 실행하기 전에 틀부터 쓰세요. 에이전트가 무엇에 접근할 수 있는지, 출처를 어떻게 밝히는지, 좋은 결과물은 어떤 모습인지.
- 마지막에 승인 단계를 남겨 두세요. 직접 검토하는 draft PR처럼요.
- 결과가 아니라 하네스를 고치세요. 에이전트가 틀리면, 틀에서 무엇이 빠져 있었는지 스스로 물어보세요.
그다음에야 범위를 넓히세요.
첫 번째 글은 여기까지입니다! 다음에는 제 개인 에이전트인 Yellow에 대해 이야기해 드릴게요. 기대해 주세요.
다음 글도 읽고 싶으신가요?
구독하기 (RSS)